Tin tức Thisme
Lồng tiếng AI cho video bài giảng: text to speech tiếng Việt và quy trình duyệt
Lồng tiếng AI là dùng công nghệ chuyển văn bản thành giọng nói (text to speech) để tạo lời đọc tiếng Việt cho video bài giảng và học liệu. Cách này thay cho thu âm khi nội dung cần cập nhật thường xuyên hoặc cần nhiều phiên bản. Muốn dùng được, bạn cần một kịch bản đọc đã duyệt, chọn giọng và tốc độ phù hợp, sửa cách đọc số, tên riêng và thuật ngữ, ghép khớp vào video, rồi có người phụ trách nghe lại trước khi phát hành. Không nhân bản giọng của bất kỳ ai khi chưa có đồng ý bằng văn bản.[1]
Lồng tiếng AI là gì và khác gì thu âm giọng người?
Về kỹ thuật, đây là tổng hợp tiếng nói. Hệ thống nhận văn bản, chuẩn hóa những phần như số và từ viết tắt thành chữ đọc được, rồi sinh ra âm thanh. Trong bối cảnh học liệu, “AI đọc thay” và “text to speech” nói về cùng một việc: biến lời dẫn đã viết thành file giọng để đặt vào video.[1]
- Giọng có sẵn của công cụ: chọn từ danh sách nhà cung cấp công bố, dùng được ngay, không gắn với người thật nào trong đơn vị.
- Giọng tùy chỉnh hoặc nhân bản: tạo từ bản thu của một người cụ thể, chỉ làm khi người đó đồng ý bằng văn bản và việc này nằm trong phạm vi dự án.
- Thu âm giọng thật của giảng viên: phải hẹn lịch, cần phòng thu và người dựng, nhưng giữ được cảm xúc và dấu ấn cá nhân.
Giọng tổng hợp chỉ tạo ra bản đọc. Nó không thay vai trò chuyên môn của giảng viên: nội dung lời dẫn vẫn do chuyên gia viết hoặc duyệt, và người học vẫn cần một kênh để hỏi người dạy khi gặp chỗ khó. Nếu người học thấy mất kết nối, nguyên nhân thường nằm ở việc cả khóa không còn dấu vết nào của người dạy, chứ không chỉ ở giọng đọc.
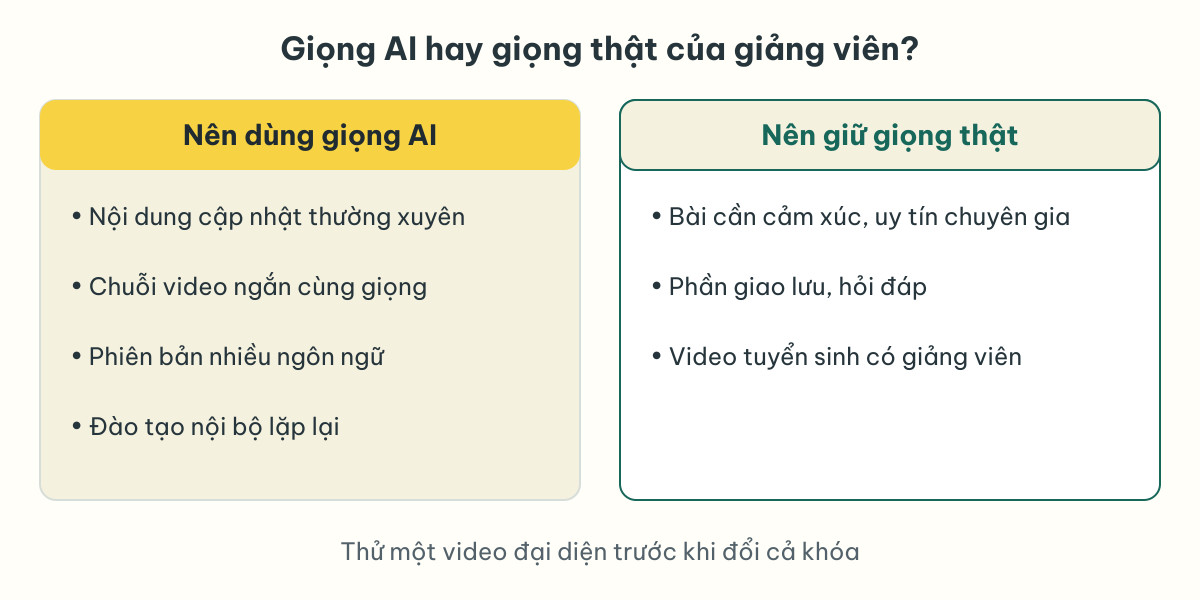
Khi nào nên dùng giọng AI thay vì thu âm lại?
Giọng máy phát huy khi nội dung thay đổi nhiều hơn cảm xúc cần truyền đạt. Những trường hợp hợp lý nhất:
- Bài giảng có số liệu, quy định hoặc quy trình thay đổi theo từng đợt: chỉ sửa đoạn văn bản liên quan rồi tạo lại đúng đoạn giọng đó.
- Chuỗi video ngắn cần cùng một giọng, ví dụ hướng dẫn thao tác trên phần mềm.
- Phiên bản nhiều ngôn ngữ của cùng một bài học.
- Nội dung đào tạo nội bộ lặp lại mỗi đợt hội nhập nhân sự mới.
Ngược lại, nên giữ giọng thật khi bài cần cảm xúc hoặc uy tín cá nhân của chuyên gia, khi có phần giao lưu, hỏi đáp, hoặc khi video tuyển sinh lấy gương mặt và giọng giảng viên làm điểm nhấn. Ở những video này, người xem đang làm quen với chính người sẽ dạy mình, và giọng máy làm mất đúng điều họ cần thấy.
Quy trình lồng tiếng AI cho video bài giảng gồm những bước nào?
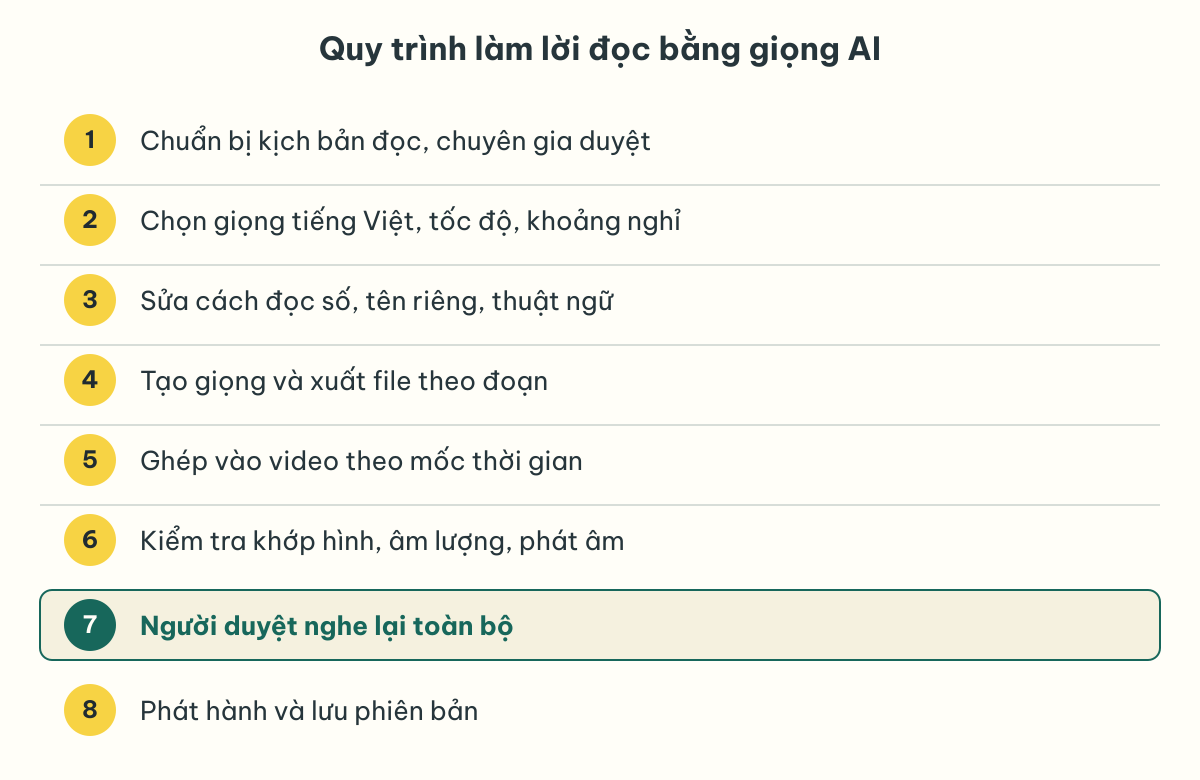
Một quy trình đủ dùng gồm tám bước. Làm đúng thứ tự để không phải quay lại sửa ở khâu tốn công nhất:
- Chuẩn bị kịch bản đọc từ tài liệu được phép sử dụng, chuyên gia duyệt nội dung.
- Chọn giọng tiếng Việt, tốc độ và khoảng nghỉ.
- Sửa cách đọc số, ngày tháng, tên riêng, từ viết tắt, thuật ngữ.
- Tạo giọng và xuất file theo từng đoạn.
- Ghép file giọng vào video, căn theo mốc thời gian.
- Kiểm tra khớp hình, âm lượng và phát âm.
- Người duyệt nghe lại toàn bộ bản đọc.
- Phát hành, lưu văn bản lời đọc, bảng thuật ngữ và file giọng theo phiên bản.
Chuẩn bị kịch bản đọc từ tài liệu giảng dạy
Slide không phải là thứ để máy đọc. Slide liệt kê ý; lời đọc phải viết như nói: câu ngắn, mỗi câu một ý, có đánh dấu chỗ ngắt và chỗ nhấn. Một gạch đầu dòng kiểu “Quy trình đối soát: tiếp nhận, kiểm tra, xác nhận” cần được viết lại thành câu hoàn chỉnh, nếu không giọng máy sẽ đọc như đọc danh mục.
Chỉ dùng tài liệu được phép sử dụng, và để chuyên gia duyệt nội dung trước khi tạo giọng. Sửa một câu trong văn bản tốn vài phút; sửa sau khi đã ghép âm thanh vào video thì phải tạo lại đoạn đó và căn lại hình. Gắn mỗi đoạn lời dẫn với một cảnh hoặc mốc thời gian trong video để khâu ghép không phải đoán.
Chọn giọng, tốc độ và ngữ điệu phù hợp người học
Các dịch vụ lớn đều công bố danh sách giọng theo ngôn ngữ; ví dụ Google Cloud Text-to-Speech và dịch vụ giọng nói của Azure đều có mục tiếng Việt (mã vi-VN). Giọng có đủ tự nhiên cho bài giảng hay không thì phải tự nghe mới biết: thử vài giọng với chính một đoạn văn dài của khóa, không dùng câu mẫu của nhà cung cấp.[3][5]
Chọn giọng theo vùng miền và đối tượng người học, rồi giữ một giọng cho cả khóa; đổi giọng giữa chừng dễ khiến người học tưởng đang xem chương trình khác. Tốc độ nên vừa sức nghe, có khoảng nghỉ sau mỗi ý chính. Giọng đều đều, ngắt sai chỗ là lý do người học buông video giữa chừng. Nghe thử cả trên loa điện thoại, không chỉ trên tai nghe: bản nghe ổn trong tai nghe có thể rè hoặc khó nghe qua loa nhỏ.
Sửa cách đọc số, tên riêng, từ viết tắt và thuật ngữ
Đây là chỗ giọng máy dễ làm sai bài học nhất. Lỗi thường gặp: số thập phân, ngày tháng, đơn vị đo, mã học phần, từ tiếng Anh, tên người và từ viết tắt. Bước chuẩn hóa văn bản của hệ thống phải tự đoán cách đọc những phần mơ hồ này, nên đoán sai là chuyện thường gặp.[1]
- Viết lại thành chữ ngay trong lời dẫn khi chỉ có vài chỗ, ví dụ ghi rõ cách đọc mã học phần hoặc phân số.
- Dùng thẻ SSML nếu công cụ hỗ trợ: say-as để chỉ định đọc kiểu số hay ngày tháng, sub để đọc tên đầy đủ thay cho từ viết tắt, phoneme để chỉ định phát âm, break để chèn khoảng nghỉ, prosody để chỉnh tốc độ và cao độ.
- Dùng chức năng từ điển phát âm của công cụ cho những từ lặp lại nhiều lần trong khóa.
Lập một bảng thuật ngữ dùng chung cho cả khóa: từ gốc, cách đọc đã chốt, người chốt. Đợt sau chỉ việc áp lại bảng này thay vì sửa từ đầu. Thisme cũng làm theo cách đó khi chuyển nội dung sang ngôn ngữ khác: có bảng thuật ngữ, quy tắc biên tập, cơ chế theo dõi thay đổi từ bản gốc, và bước rà thuật ngữ trước phát hành.
Cách lồng tiếng vào video quay sẵn
Không cần dựng lại video. Việc chính là tách hoặc tắt âm gốc, đặt file giọng mới vào một rãnh âm thanh riêng, rồi căn từng đoạn theo mốc thời gian đã ghi trong văn bản lời đọc. Phần mềm dựng video quen thuộc đều làm được việc này. Nếu đội có người quen dòng lệnh, FFmpeg cho phép lấy luồng hình từ file này, luồng âm thanh từ file khác, ghép thành file mới và sao chép nguyên luồng hình mà không mã hóa lại.[9]
Video có người nói trên hình khó hơn: thay giọng mà khẩu hình không khớp sẽ lộ ngay. Với những cảnh này, chỉ thay giọng khi không cần khớp khẩu hình, hoặc chuyển sang dạng thuyết minh, hoặc chèn hình minh họa, màn hình thao tác che phần người nói. Sau đó chuẩn hóa âm lượng giữa các đoạn và giữa giọng đọc với nhạc nền, để người học không phải chỉnh loa liên tục.
Bài này không đi sâu vào dựng video bằng AI hay tạo phụ đề tự động; các chủ đề đó có bài riêng trong mục tin tức của Thisme.
Kiểm tra khớp hình và chất lượng trước khi xuất bản
- Lời đọc khớp với slide hoặc cảnh đang hiện.
- Không đọc trước khi hình hoặc chữ xuất hiện trên màn hình.
- Thuật ngữ, tên riêng, con số đọc đúng như đã chốt trong bảng.
- Không có tạp âm, đoạn lặp, đoạn cụt ở đầu hoặc cuối.
- Âm lượng đều giữa các đoạn và với nhạc nền.
Có lời đọc rồi vẫn nên kèm phụ đề hoặc bản chép lời. Hướng dẫn của W3C WAI về video và âm thanh dễ tiếp cận nêu rõ vai trò của phụ đề, bản chép lời và mô tả âm thanh. Người học ở nơi ồn hoặc khó nghe vẫn theo được bài, và bản chép lời cũng cho chuyên gia một văn bản để rà nội dung mà không phải nghe lại từ đầu.[8]
Chọn phần mềm text to speech tiếng Việt theo tiêu chí nào?
Đừng bắt đầu bằng bảng xếp hạng. Lấy một đoạn lời dẫn thật của khóa, có số, thuật ngữ và tên người, chạy thử trên vài công cụ rồi chấm theo các tiêu chí dưới đây:
- Giọng tiếng Việt: có bao nhiêu lựa chọn, vùng miền nào, đọc đoạn dài có còn tự nhiên không.
- Kiểm soát cách đọc: có từ điển phát âm không, có nhận SSML không, chỉnh được tốc độ và ngắt nghỉ không.
- Quyền sử dụng thương mại: điều khoản có cho dùng file giọng trong khóa học bán ra, video tuyển sinh, kênh mạng xã hội không.
- Xuất file: định dạng âm thanh, chất lượng, giới hạn độ dài mỗi lần tạo, có xuất theo đoạn không.
- Chi phí: tính theo ký tự, theo gói hay theo người dùng; ước theo khối lượng văn bản thật cộng số lần phải tạo lại khi sửa.
- Dữ liệu: nội dung bài giảng được gửi lên máy chủ ở đâu, nhà cung cấp có giữ hay dùng lại không, ai trong đơn vị có quyền vào tài khoản.
Quyền giọng nói: không nhân bản giọng người khác khi chưa đồng ý
Giọng nói gắn với danh tính. Deepfake âm thanh, tức giọng tổng hợp bắt chước một người thật, đã bị dùng để mạo danh và lừa đảo. Một file giọng giảng viên bị nhân bản trái phép vì thế có thể gây hại cho cả người đó lẫn đơn vị.[7]
Chính nhà cung cấp lớn cũng đặt điều kiện: tài liệu minh bạch về giọng tùy chỉnh của Microsoft yêu cầu có sự đồng ý của người cho giọng trước khi tạo giọng từ bản thu của họ.[6]
- Nhân bản giọng giảng viên hay người đọc chỉ làm khi có đồng ý bằng văn bản, ghi rõ phạm vi, thời hạn và mục đích sử dụng.
- Không ép giảng viên dùng giọng của mình; giọng có sẵn của công cụ là lựa chọn mặc định an toàn hơn.
- Ghi chú trong video hoặc mô tả khóa rằng lời đọc được tạo bằng giọng tổng hợp, nếu chính sách đơn vị yêu cầu.
- Thống nhất trước cách xử lý video đã dùng giọng một người khi họ nghỉ việc hoặc rút đồng ý: gỡ, thay giọng hay giữ đến hết hạn.
- Không đưa văn bản có dữ liệu nội bộ lên dịch vụ bên ngoài khi chưa đọc điều khoản xử lý dữ liệu.
Ở Studio học liệu AI của Thisme, nhân bản giọng và nhân vật ảo chỉ thực hiện khi có trong phạm vi đã thống nhất. Hai bên chốt trước định dạng bàn giao, ngôn ngữ, số vòng sửa và nền tảng nhận nội dung.
Ai duyệt, nghe lại và lưu phiên bản?
- Chuyên gia: duyệt nội dung lời dẫn, số liệu và thuật ngữ trước khi tạo giọng.
- Người phụ trách học liệu: nghe lại bản đọc, kiểm tra khớp hình, ghi lỗi phát âm vào bảng thuật ngữ.
- Người có thẩm quyền: chốt bản phát hành.
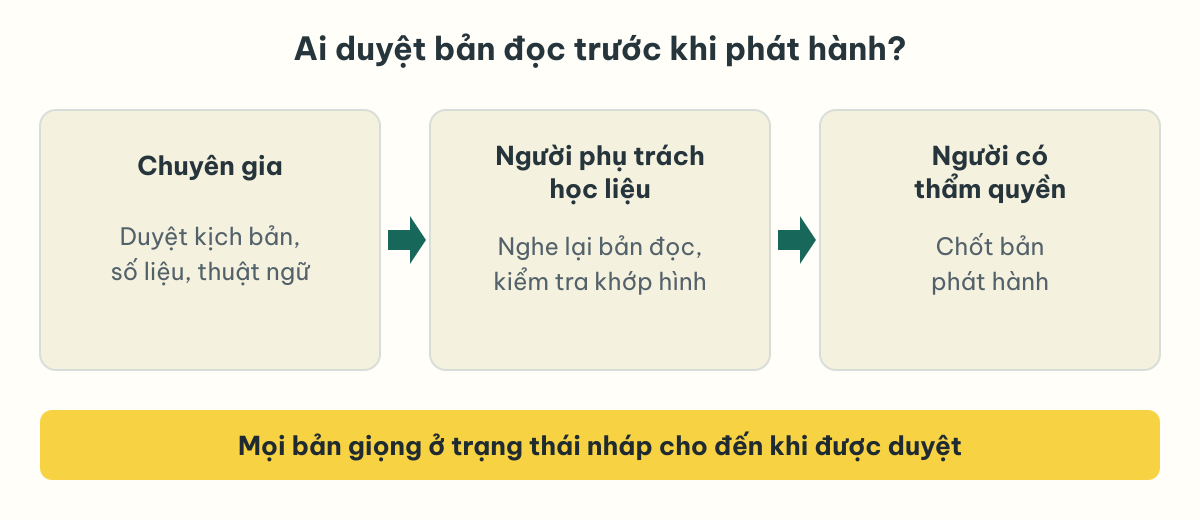
Mỗi bản giọng ở trạng thái nháp cho đến khi người có trách nhiệm kiểm tra và duyệt; Studio của Thisme áp dụng nguyên tắc này cho mọi đầu ra, kèm phân công, góp ý và quản lý phiên bản. Lưu văn bản lời đọc, bảng thuật ngữ và file giọng theo phiên bản, để lần cập nhật sau chỉ tạo lại đoạn thay đổi chứ không làm lại cả video.
Nếu lời đọc dùng cho video tuyển sinh, nguyên tắc vẫn vậy. Dịch vụ Nội dung tuyển sinh của Thisme có thể bàn giao kịch bản video từ học liệu sẵn có, và chuyên gia của khách hàng kiểm tra số liệu cùng nội dung chuyên môn trước khi xuất bản. Quay video mới không nằm trong phạm vi mặc định.
Đo hiệu quả bằng tỷ lệ bản đọc được duyệt ngay, số lỗi phát âm hoặc thuật ngữ, thời gian chuyên gia phải sửa và khả năng dùng lại ở đợt sau. Số video tạo ra chỉ có ý nghĩa khi từng video đúng nội dung, đúng giọng và đủ điều kiện phát hành.
Khi nào nên nhờ đội ngũ đồng hành?
Khi đơn vị có nhiều khóa, nhiều ngôn ngữ, hoặc cần một dây chuyền từ tài liệu đến video có giọng đọc, phụ đề và bản chép lời được duyệt thống nhất, tự ghép từng công cụ rời dễ vỡ ở khâu bàn giao. Studio học liệu AI của Thisme hỗ trợ sản xuất video từ lời dẫn, phân cảnh hình ảnh, giọng đọc, biên tập từ tài sản được phép, bản chép lời, phụ đề đến mục lục chủ đề, trên một quy trình duyệt gọn mà chuyên gia chỉ cần sửa điểm chuyên môn.
Nếu bạn đang có bài giảng, video quay sẵn hoặc tài liệu chuyên môn và muốn làm lồng tiếng AI có quy trình duyệt rõ ràng, hãy đăng ký buổi khảo sát. Chúng ta sẽ cùng chọn một khóa hoặc một nhóm video để làm thử, chốt kịch bản đọc, giọng, bảng thuật ngữ, định dạng bàn giao và người duyệt theo những việc đã thống nhất.
Nguồn tham khảo
- Speech synthesis – Wikipedia
- Speech Synthesis Markup Language (SSML) Version 1.1 – W3C
- Google Cloud Text-to-Speech – Supported voices and languages
- Google Cloud Text-to-Speech – Speech Synthesis Markup Language (SSML)
- Language and voice support for the Speech service – Microsoft Learn
- Transparency note for custom neural voice – Microsoft Learn
- Audio deepfake – Wikipedia
- Making Audio and Video Media Accessible – W3C WAI
- ffmpeg Documentation