Tin tức Thisme
RAG chatbot là gì? Cách chatbot trả lời theo tài liệu, dẫn nguồn và vì sao vẫn có thể sai
RAG chatbot (Retrieval-Augmented Generation, tạm hiểu là sinh câu trả lời có bước truy xuất tài liệu) là chatbot tìm các đoạn liên quan trong kho tài liệu được phép sử dụng trước, rồi mới để mô hình ngôn ngữ soạn câu trả lời dựa trên các đoạn đó và dẫn lại nguồn. Cách này giúp câu trả lời bám tài liệu của đơn vị hơn chatbot chỉ dựa vào kiến thức có sẵn trong mô hình. Tuy vậy, nó vẫn có thể sai khi tìm nhầm đoạn, khi tài liệu đã cũ hoặc khi mô hình diễn giải lệch. Trước khi cho học viên hay nhân viên dùng, bạn cần ba thứ: dẫn nguồn, phân quyền tài liệu và một bộ câu hỏi mẫu để kiểm tra.[1]
RAG chatbot là gì, và tên gọi ấy nói lên điều gì?
Tên gọi ghép hai việc. Retrieval là truy xuất: tìm trong kho những đoạn có liên quan tới câu hỏi. Generation là sinh nội dung: mô hình ngôn ngữ lớn, tức loại mô hình AI được huấn luyện trên lượng văn bản rất lớn để đọc và viết như người, viết ra lời giải đáp từ những đoạn vừa tìm được. Thuật ngữ này được Lewis và cộng sự giới thiệu trong một bài báo năm 2020, mô tả cách kết hợp kiến thức nằm sẵn trong tham số của mô hình với một bộ nhớ ngoài là chỉ mục tài liệu được truy xuất.[2]
Cần tách hai khái niệm hay bị dùng lẫn. Knowledge base là kho tài liệu được quản trị: ai phụ trách, bản nào có hiệu lực, ai được đọc. Chatbot kiểu RAG chỉ là một cách hỏi đáp trên kho đó. Kho lộn xộn thì chatbot cũng trả lời lộn xộn, dù mô hình tốt đến đâu.
Chatbot truy xuất tài liệu hoạt động qua những bước nào?
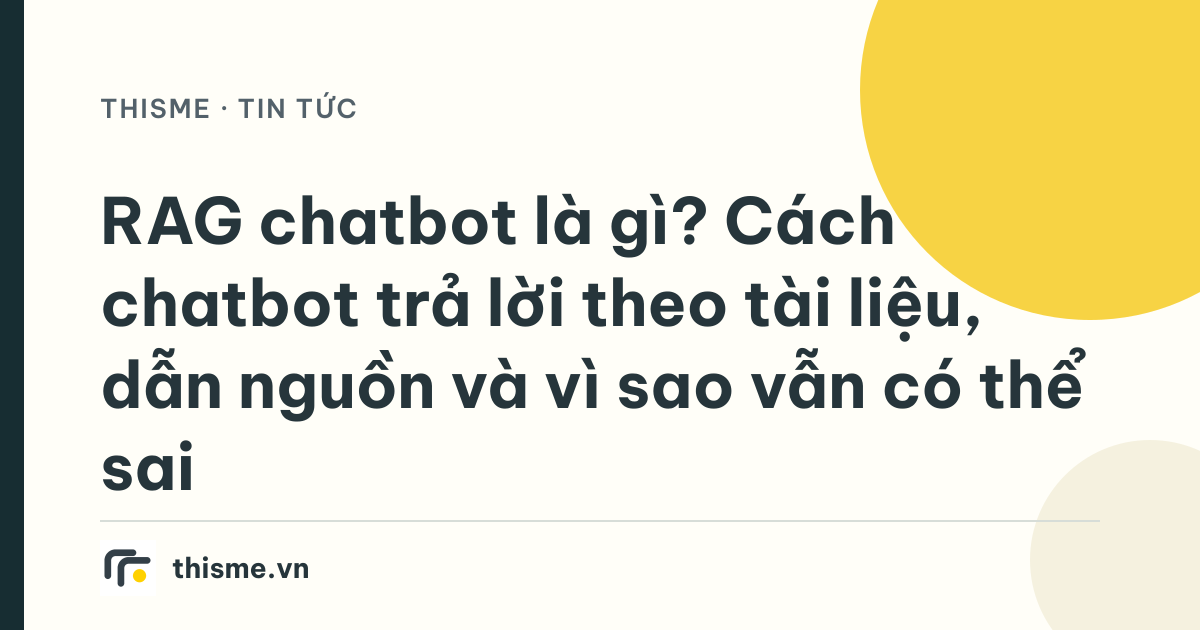
Mỗi nhà cung cấp dùng công cụ khác nhau, nhưng luồng cơ bản giống nhau: tìm nội dung liên quan trong chỉ mục trước, đưa nội dung đó cho mô hình, rồi mô hình viết phần trả lời có căn cứ.[3][4]
- Chuẩn bị tài liệu: chọn nguồn chính thức, chia thành đoạn nhỏ và lập chỉ mục để máy tìm được.
- Người dùng đặt câu hỏi bằng lời thường, không cần nhớ đúng tên tài liệu.
- Hệ thống lọc theo quyền của người hỏi, rồi tìm những đoạn sát nghĩa nhất trong phần họ được phép xem.
- Mô hình ngôn ngữ soạn câu trả lời chỉ từ các đoạn tìm được, không lấy thêm từ trí nhớ chung.
- Màn hình hiển thị đoạn trích, tên tài liệu, phiên bản, và báo rõ khi không đủ căn cứ để trả lời.
Khác gì chatbot chỉ dựa vào mô hình?
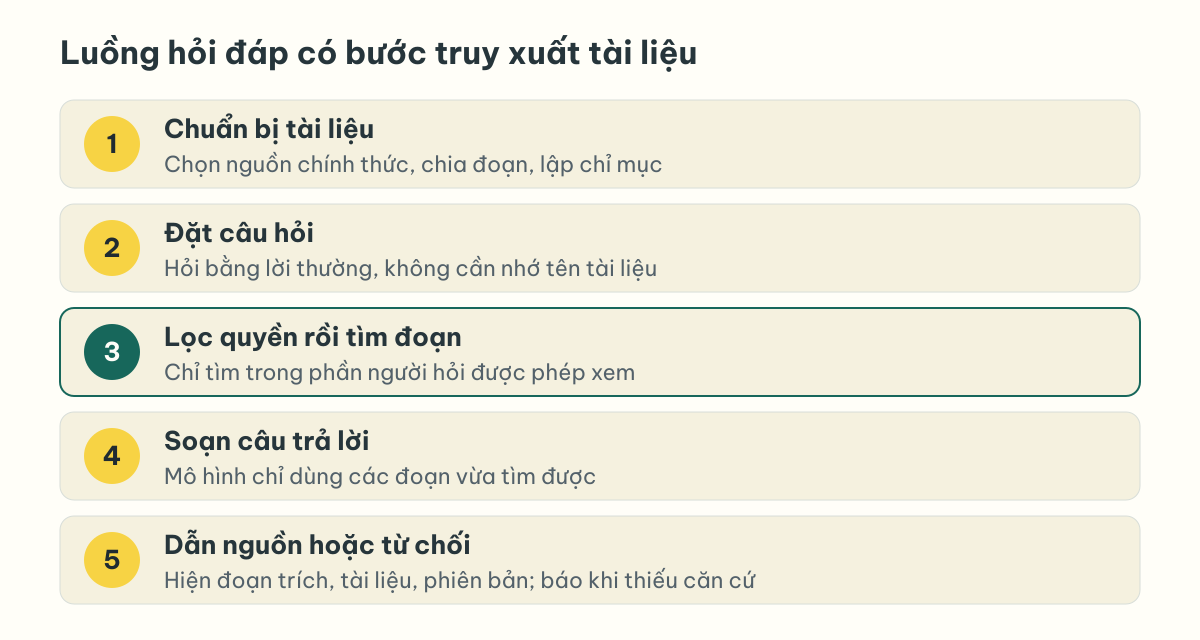
Chatbot chỉ dựa vào mô hình trả lời từ những gì mô hình đã học lúc huấn luyện. Nó không biết quy chế riêng của trung tâm bạn, không biết thông báo vừa ban hành tháng trước, và khó chỉ ra một câu cụ thể lấy từ đâu. Với RAG, căn cứ đến từ tài liệu đơn vị cung cấp. Muốn cập nhật, bạn thay tài liệu trong kho; không cần huấn luyện lại mô hình.[1][3]
- Nguồn kiến thức: một bên là dữ liệu huấn luyện chung; bên kia là tài liệu đơn vị đưa vào kho.
- Cập nhật: một bên phải chờ mô hình mới; bên kia chỉ cần thay hoặc ngừng dùng tài liệu.
- Dẫn nguồn: một bên thường không chỉ ra được; bên kia hiển thị đoạn trích và tài liệu gốc.
- Phạm vi: một bên trả lời gần như mọi chủ đề; bên kia giới hạn trong phần tài liệu đã duyệt.
- Khi thiếu thông tin: một bên dễ đoán cho trôi; bên kia có thể được thiết kế để báo không đủ căn cứ và chuyển câu hỏi đi.
Vì sao đã tìm theo tài liệu mà vẫn có thể trả lời sai?
Bước truy xuất giúp câu trả lời bám tài liệu hơn, nhưng không loại bỏ được sai sót. Mô hình vẫn có thể tạo ra câu nghe rất hợp lý mà không khớp với nguồn, hiện tượng thường gọi là ảo giác (hallucination). Hồ sơ rủi ro AI tạo sinh NIST AI 600-1 gọi hiện tượng này là confabulation và xếp nó vào nhóm rủi ro cần được quản lý.[1][7][8]
Những nguyên nhân sai thường gặp
- Tìm nhầm đoạn: học viên hỏi “nghỉ học giữa chừng” trong khi văn bản viết “bảo lưu kết quả”, hoặc điều kiện ngoại lệ nằm ở đoạn bên cạnh và bị cắt mất.
- Tài liệu cũ hoặc trùng: quy chế năm trước và năm nay cùng nằm trong kho, chatbot lấy nhầm bản đã hết hiệu lực.
- Diễn giải lệch dù nguồn đúng: phần tóm tắt bỏ mất một điều kiện, hoặc gộp hai quy định thành một.
- Cố trả lời khi tài liệu thiếu thông tin, thay vì nói rõ là không đủ căn cứ.
- Câu lệnh độc hại chèn trong tài liệu hay trong câu hỏi (prompt injection) khiến mô hình làm khác chỉ dẫn ban đầu; OWASP liệt kê đây là một rủi ro chính của ứng dụng dùng mô hình ngôn ngữ lớn.
Mỗi nguyên nhân cần một cách chặn riêng: chia đoạn theo điều khoản để giảm tìm nhầm, quản lý phiên bản để gỡ bản cũ, bắt buộc hiện nguồn để lộ ra chỗ diễn giải lệch, cho phép từ chối khi thiếu căn cứ, và coi nội dung trong tài liệu là dữ liệu chứ không phải mệnh lệnh. Các phần dưới đi vào từng lớp kiểm soát.[9]
Dẫn nguồn và phân quyền tài liệu: hai lớp kiểm soát cần có
Dẫn nguồn nghĩa là mỗi lời đáp đi kèm đoạn liên quan, tên tài liệu và phiên bản, để người hỏi tự mở ra đối chiếu. Giáo vụ chỉ cần liếc đoạn trích là biết chatbot có đọc đúng điều khoản hay không. Nhưng dẫn nguồn giúp phát hiện sai nhanh, nó không tự bảo đảm nội dung đúng: một câu tóm tắt lệch vẫn có thể đứng cạnh một nguồn chuẩn.
Phân quyền nghĩa là hệ thống chỉ tìm trong phần tài liệu người hỏi được phép xem, và lọc trước khi đưa bất kỳ đoạn nào cho mô hình. Kỹ thuật này thường gọi là cắt tỉa kết quả theo quyền (security trimming): kết quả tìm kiếm được lọc theo danh tính hoặc nhóm của người dùng. Nếu chỉ lọc sau khi mô hình đã đọc, nội dung nhạy cảm vẫn có thể lọt vào câu trả lời.[6][9]
- Học viên hỏi về quy chế học vụ: chatbot chỉ tìm trong quy chế và thông báo công khai.
- Giáo vụ hỏi cùng câu đó: thấy thêm hướng dẫn xử lý nội bộ, mẫu biểu và ghi chú nghiệp vụ.
- Tài liệu tài chính, hồ sơ cá nhân: nằm ngoài phạm vi của chatbot dành cho học viên ngay từ đầu.
Trong Knowledge Base AI của Thisme, AI chỉ tìm, tổng hợp và đề xuất dựa trên tài liệu mà người dùng có quyền xem. AI không tự sửa hoặc xuất bản nội dung. Người phụ trách vẫn quyết định phiên bản nào có hiệu lực và khi nào cần cập nhật. Kết quả tìm kiếm hiển thị đoạn liên quan, nguồn và phiên bản sau khi đã lọc quyền.
Chuẩn bị tài liệu cho chatbot hỏi đáp thế nào?
Phần tốn công nhất thường không nằm ở việc gắn chatbot mà ở tài liệu: chọn nguồn, chia đoạn, gỡ bản cũ, gắn quyền. Điều đáng mừng là bạn không cần gom sạch mọi thứ ngay từ đầu. Hãy chọn một quy trình hoặc nhóm câu hỏi quan trọng, xác định nguồn chính thức, quyền đọc và người duyệt, kiểm tra kỹ rồi mới mở rộng. Với dữ liệu cũng vậy: chọn một nhóm nguồn ưu tiên, kiểm tra kết quả trên mẫu nhỏ, sau đó mới thêm từng nguồn.
Chọn nguồn chính thức và người phụ trách
- Lập danh sách tài liệu được dùng để trả lời và ghi rõ bản nào là bản chính thức; người làm là trưởng giáo vụ hoặc người quản lý học liệu.
- Gắn mỗi tài liệu với một người chịu trách nhiệm cập nhật và một nhóm được đọc.
- Loại khỏi phạm vi trả lời bản nháp, bản sao lưu truyền qua nhóm chat và bản đã hết hiệu lực.
- Chỉ đưa vào tài liệu đơn vị có quyền sử dụng; tài liệu của đối tác cần xem lại giấy phép trước.
Chia đoạn sao cho đoạn tìm được vẫn đủ nghĩa
Chia đoạn (chunking) là cắt tài liệu dài thành những phần nhỏ để hệ thống tìm đúng chỗ thay vì trả về cả tệp. Cách chia ảnh hưởng trực tiếp tới chất lượng truy xuất: đoạn quá ngắn mất ngữ cảnh, đoạn quá dài lẫn nhiều ý. Nhiều cách làm còn cho các đoạn chồng lên nhau một phần để không cắt rời một ý.[5]
- Với quy chế, chia theo điều, khoản, mục có tiêu đề thay vì cắt theo độ dài cố định.
- Gắn kèm mỗi đoạn tên tài liệu, chương và số điều, để phần dẫn nguồn chỉ thẳng tới chỗ cần đọc.
- Giữ điều kiện ngoại lệ cùng đoạn với quy định chính, hoặc ghi chú liên kết giữa hai đoạn.
- Bảng biểu, phụ lục và file scan cần chuyển sang văn bản đọc được và kiểm tra lại trước khi đưa vào.
Cập nhật phiên bản khi quy chế thay đổi
Mỗi tài liệu nên có phiên bản, ngày hiệu lực và lịch rà soát. Khi có bản mới, bản cũ phải ra khỏi phạm vi trả lời ngay, chứ không chỉ đổi tên thành “cũ” rồi để nguyên trong thư mục. Trong Knowledge Base AI, mỗi nội dung có người phụ trách, thông tin chú thích, quyền đọc hoặc sửa, lịch rà soát và lịch sử phiên bản. Quy trình nháp, góp ý, duyệt, xuất bản và ngừng dùng giữ một nguồn tham chiếu rõ ràng thay vì nhiều bản sao lưu truyền không kiểm soát.
Phiên bản mới chỉ là một phần. Lưu được tệp chưa có nghĩa là tìm được và đối chiếu được: dữ liệu trùng, thiếu thông tin chú thích, đặt tên không thống nhất hay khó xác định bản nào mới nhất đều khiến chatbot tìm nhầm. Chuẩn hóa tên gọi, gỡ bản trùng và gắn chủ đề là việc nên làm trước khi cấp dữ liệu cho AI, và người phụ trách kiểm tra, duyệt kết quả đó.
Đánh giá câu trả lời bằng bộ câu hỏi mẫu
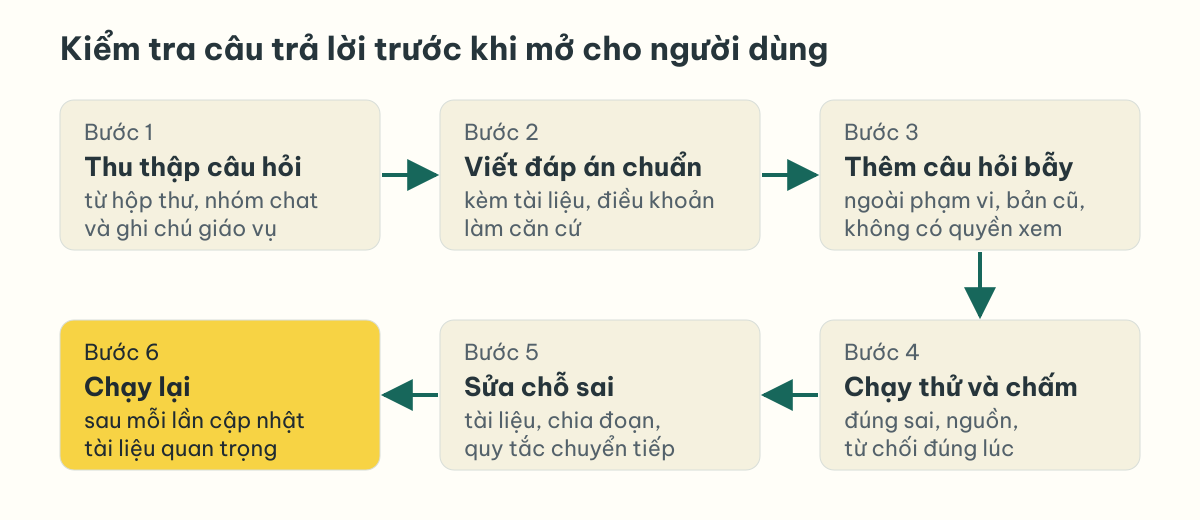
Trước khi mở cho người dùng thật, hãy lập một bộ câu hỏi lấy từ những gì giáo vụ và tư vấn viên nhận hằng ngày, kèm đáp án đúng và tài liệu nguồn mà bạn kỳ vọng chatbot trích ra. Khung quản lý rủi ro AI tạo sinh của NIST cũng khuyến nghị đánh giá và giám sát có con người tham gia, thay vì tin vào lần chạy thử đầu tiên.[8]
- Thu thập câu hỏi thường gặp từ hộp thư, nhóm chat và sổ ghi chú của giáo vụ, tư vấn viên.
- Viết đáp án chuẩn cho từng câu, ghi rõ tài liệu và điều khoản làm căn cứ; đội chuyên môn duyệt.
- Thêm câu hỏi bẫy: ngoài phạm vi, hỏi theo bản quy chế cũ, hỏi về tài liệu người hỏi không có quyền xem.
- Chạy thử và chấm từng câu: đúng hay sai, nguồn có khớp không, có từ chối đúng lúc không.
- Sửa tài liệu, cách chia đoạn hoặc quy tắc chuyển tiếp ở chỗ sai, rồi chạy lại.
- Chạy lại toàn bộ sau mỗi lần cập nhật tài liệu quan trọng, trước khi mở thêm cho nhóm người dùng mới.
Nên đo tỷ lệ câu trả lời có nguồn đúng, số câu phải từ chối vì thiếu căn cứ, thời gian cập nhật phiên bản và phản hồi của người duyệt. Đừng lấy số tài liệu đã nạp làm thước đo: kho lớn không có giá trị nếu quyền sai, nội dung cũ hoặc người dùng vẫn phải hỏi lại chuyên gia. Knowledge Base AI có bộ câu hỏi kiểm tra chất lượng, cùng nhật ký sử dụng và lịch sử chỉnh sửa để đối chiếu.
Ví dụ: hỏi đáp quy chế học vụ và tài liệu nội bộ
Hai tình huống dưới đây là ví dụ minh họa để hình dung cách vận hành, không phải câu chuyện của một khách hàng cụ thể.
Một học viên hỏi: “Em phải đi công tác dài ngày, có được bảo lưu không?”. Chatbot tìm trong quy chế hiện hành, nêu điều kiện bảo lưu và dẫn đúng điều khoản cùng phiên bản. Nếu học viên rơi vào trường hợp ngoại lệ hoặc cần ai đó quyết định, câu hỏi được chuyển cho giáo vụ kèm bối cảnh: câu hỏi gốc, đoạn quy chế đã tìm, thông tin học viên đã nêu. Giáo vụ nhận một yêu cầu có người xử lý, mức ưu tiên và lịch sử rõ ràng, không phải hỏi lại từ đầu.
Một tư vấn viên hỏi quy trình xử lý hồ sơ nộp trễ hạn. Chatbot chỉ tìm trong hướng dẫn nội bộ mà nhân viên này được đọc và dẫn phiên bản đang có hiệu lực. Nếu kho không có câu trả lời, hệ thống báo thẳng như vậy; câu hỏi được chuyển cho người phụ trách, đồng thời trở thành tín hiệu cho nội dung cần bổ sung.
Khi nào đơn vị đào tạo nên bắt đầu với chatbot hỏi đáp theo tài liệu?
- Giáo vụ, tư vấn viên trả lời lặp lại cùng một nhóm câu hỏi về thủ tục, lịch học, quy chế.
- Quy trình và chính sách có nhiều phiên bản, nhân viên không chắc nguồn nào còn hiệu lực.
- Câu trả lời phụ thuộc vào vài người làm lâu năm; họ nghỉ phép là cả bộ phận phải chờ.
Chưa nên bắt đầu khi đơn vị chưa xác định được đâu là tài liệu chính thức hoặc chưa có ai nhận trách nhiệm cập nhật. Khi đó chatbot chỉ giúp lan truyền nhanh hơn những thông tin chưa ai kiểm.
Nếu đã sẵn sàng, hãy bắt đầu nhỏ: một quy trình hoặc một nhóm câu hỏi quan trọng, kiểm tra câu trả lời, trích dẫn và các trường hợp phải từ chối rồi mới mở rộng. Bạn cũng không phải bỏ drive, SharePoint, wiki hay cổng nội bộ đang dùng. Kho tri thức có thể triển khai mới hoặc tích hợp với kho tài liệu hiện có; việc kết nối được chốt theo phạm vi đã thống nhất sau khi kiểm tra.
Một RAG chatbot đáng tin bắt đầu từ tài liệu được quản trị, không phải từ mô hình. Bạn đang có quy chế học vụ, quy trình hoặc tài liệu nội bộ mà giáo vụ, tư vấn viên phải trả lời đi trả lời lại? Đăng ký buổi khảo sát để chúng ta cùng chọn một nhóm tài liệu chính thức, thống nhất người phụ trách, quyền đọc và bộ câu hỏi mẫu, rồi làm thử hỏi đáp có dẫn nguồn với Knowledge Base AI trước khi mở rộng.
Nguồn tham khảo
- Retrieval-augmented generation – Wikipedia
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (arXiv:2005.11401)
- What is RAG (Retrieval-Augmented Generation)? – AWS
- Retrieval Augmented Generation (RAG) in Azure AI Search – Microsoft Learn
- Chunk large documents for vector search solutions – Microsoft Learn
- Security filters for trimming results in Azure AI Search – Microsoft Learn
- Hallucination (artificial intelligence) – Wikipedia
- NIST AI 600-1: Artificial Intelligence Risk Management Framework – Generative Artificial Intelligence Profile
- OWASP Top 10 for Large Language Model Applications